// caso-studio
Frontwire
Cos'è
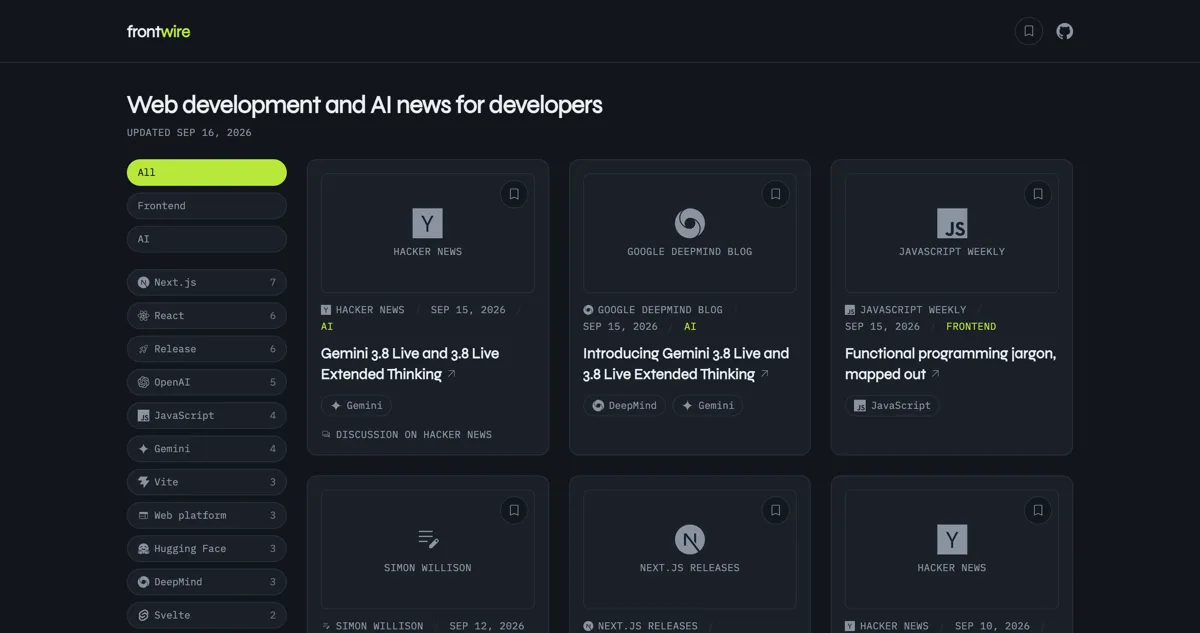
Frontwire è la rassegna di notizie di web development che volevo leggere: framework frontend (Nuxt, Next, Vue, React, Vite) e l'AI che riguarda chi scrive codice — modelli, API, strumenti per sviluppatori. L'AI applicata ad altri campi, le notizie aziendali e i round di finanziamento restano fuori.
L'archivio è pensato per essere letto per intero: al massimo 3 articoli per fonte, i più recenti, entro 30 giorni. Una trentina in tutto. Non è un feed infinito, è una pagina che finisce.
Il problema
Le notizie che mi servono sono sparse su venti blog ufficiali, tre newsletter settimanali e Hacker News. Gli aggregatori generalisti annegano il frontend nel resto; i reader RSS mi restituivano il problema di partenza, cioè troppa roba.
Il vincolo vero però era un altro: zero costi. Niente database, niente server, niente API a pagamento. Il che esclude in partenza la soluzione ovvia (un backend che fa polling e una tabella) e obbliga a chiedersi dove vivano i dati.
Come funziona
I dati vivono nel repository. Il sito è statico.
- Una GitHub Action pianificata ogni 6 ore scarica le fonti, normalizza gli articoli, rimuove i duplicati, assegna i tag e scarta gli articoli AI che non riguardano chi sviluppa
- Il risultato viene scritto in
data/articles.jsone committato sumaindal bot - Ogni push su
main, compresi quelli del bot, fa ripartire il deploy statico su Vercel
Il commit del bot è il trigger del deploy. Non serve nient'altro: niente webhook, niente revalidate, niente cron su un server che non ho.
Solo feed RSS/Atom e API ufficiali, mai scraping. Gli articoli non vengono mai ripubblicati per intero: l'archivio tiene l'estratto della fonte e linka l'originale, con le note di rilascio di GitHub come unica eccezione.
Il tipo Article, il vocabolario dei tag e il registro delle fonti vivono in shared/, importato sia dall'app che dalla pipeline: una sola fonte di verità per lo schema.
Dettagli di cui vado fiero
Lo stesso articolo da due fonti collassa in uno. L'id è un hash dell'URL normalizzato: parametri di tracking, www., slash finale, fragment e ordine dei parametri non contano. Quando un post del blog di React arriva anche da This Week In React, è già lo stesso record.
const normalized = new URL(url);
normalized.hostname = normalized.hostname.replace(/^www\./, "");
normalized.hash = "";
// Copy the keys first: deleting while iterating searchParams skips entries.
for (const key of [...normalized.searchParams.keys()]) {
  if (TRACKING_PARAM.test(key)) normalized.searchParams.delete(key);
}
normalized.searchParams.sort();
Il merge non riscrive mai il passato. Un articolo già archiviato non viene aggiornato dal feed: entra solo se l'id è nuovo. Poi valgono i due limiti — finestra di 30 giorni e tetto di 3 per fonte — e l'ordinamento è stabile, ties risolti per id. Gli stessi dati serializzano sempre negli stessi byte, quindi il bot non genera commit rumore quando non è cambiato niente.
Il filtro di pertinenza è una regex, non un classificatore. Un articolo AI entra solo se il titolo cita un modello con la versione o un termine da sviluppatore. È una scelta di budget diventata una scelta di design: le regole sono leggibili, testabili e si tarano in un file solo.
// A model family followed by a version: `GPT-6`, `o3`, `Claude Opus 5`, `DeepSeek-R2`…
const MODEL_VERSION = /gpt[-‑ ]?\d|\bo\d\b|\bclaude(?: (?:opus|sonnet|haiku))? ?\d|…/i;
I filtri stanno nella query, non in uno stato locale. Categoria e tag vivono nell'URL (/?category=ai&tags=react,nextjs), quindi ogni vista filtrata è condivisibile e il tasto Indietro riporta ai filtri precedenti. I filtri però restano vuoti fino al mount: la home è prerenderizzata e non ha query, e filtrare durante l'hydration farebbe divergere l'HTML del client da quello del server.
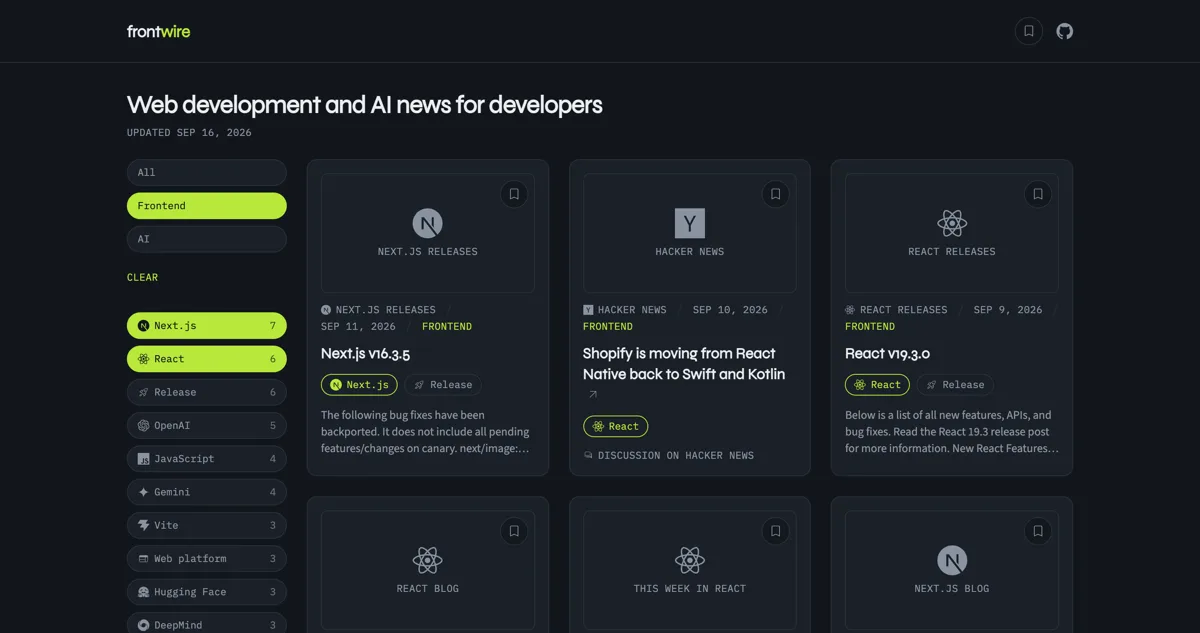
I preferiti salvano una copia, non un riferimento. Niente account e niente database: la lista sta nel localStorage. Quello che si legge da lì non è di fiducia — si modifica a mano e sopravvive ai rilasci — quindi ogni voce passa da un controllo di forma contro i vocabolari reali di fonti e tag, non solo contro i tipi: un sourceId inventato manderebbe la card a cercare l'icona di una fonte che non esiste.
Il processo
Qui il confronto con Echoes è la parte interessante.
Su Echoes il vincolo era scrivere tutto a mano: l'AI faceva da reviewer, mai da autore, perché stavo imparando React e Next.js e non volevo farmeli generare. Su Frontwire il vincolo è l'opposto: il codice lo scrive l'agente, io dirigo. Non perché sia più comodo, ma perché è l'altra competenza da esercitare, e perché il tempo per seguire riga per riga un progetto personale non ce l'avevo.
Dirigere però non vuol dire delegare e sperare. Quello che ho scritto io è il contorno:
- Un working agreement nel repo (
CLAUDE.md): prodotto, architettura, stile del codice, regole per i commenti, policy di git. È il documento che l'agente legge a ogni sessione, e le regole valgono anche per il codice che scrive lui - Una spec di design per ogni tappa, discussa prima di scrivere codice. Sette tappe, sette documenti — il perché delle scelte sta lì, non nei messaggi di commit
- Le decisioni di prodotto e infrastruttura, sempre mie: quali fonti entrano, quale tetto per fonte, riassunti AI sì o no, come si gestisce il deploy
- Le azioni verso l'esterno (push, merge, lancio dei workflow) solo su mio via libera
I commenti seguono A Philosophy of Software Design: registrano quello che era nella testa di chi ha progettato il codice e che il codice da solo non dice. È la regola che ha alzato di più la qualità dell'output, perché costringe a spiegare le decisioni invece di descrivere le righe.
I test sono Vitest sulla logica pura della pipeline — parsing dei feed, normalizzazione, deduplica, tag — con fixture locali, mai chiamate di rete. Un test d'integrità su articles.json fa anche da cancello nell'Action: se fallisce, niente commit.
Cosa ho imparato
- Un vincolo di budget è un vincolo di architettura. "Niente servizi a pagamento" ha deciso il filtro (regex e non classificatore), l'assenza di riassunti, la persistenza (JSON nel repo) e il modello di deploy. Non è stata una rinuncia in ognuno di quei punti: è stato il criterio che li ha resi coerenti tra loro
- Scrivere la spec prima costa poco e si ripaga subito, e vale a prescindere da chi scrive il codice — vale con un agente, varrebbe con un collega
- Fidarsi dei dati altrui è il bug. Feed,
localStorage, id delle fonti: tutto arriva da fuori e tutto va validato contro il vocabolario reale, non contro il tipo TypeScript, che a runtime non esiste
Limiti consapevoli
Niente riassunti AI: il provider che avevo previsto è stato ritirato, e con i feed reali quasi nessun articolo ha abbastanza testo da riassumere — i blog portano una descrizione di una riga e non faccio scraping. Il feed di Anthropic è un mirror della community, quindi una dipendenza esterna che può sparire. Il filtro di pertinenza guarda solo il titolo: qualche falso negativo passa.
In roadmap: nuove fonti già valutate (Astro, Tailwind, WebKit) e una pagina che spieghi al lettore perché una certa notizia è finita lì dentro.